服务起不来:存活探针时间太短!
目录
十月十八日,杨振宁先生逝世,缅怀,曾几何时,我也很热爱物理。
问题描述
我配置了k8s测试架构,三台机器关闭防火墙和setenforce0已经配好,各自访问百度没问题,一台master和两台node,现在在master上进行了pod创建操作,一个pod-1放到了node02,一个pod-2被放到node01。首先两个pod都拉取的是同一个nginx镜像,且标签都是myapp,pod建立起来之后,我创建了一个svc,标签什么的配置都没问题。现在出现问题是,在master访问svc的clusterIP时候,本应该是负载均衡到两个pod,现在只能访问pod-2,但是在node02机器上能访问到pod-1而其他的master和node01访问不到pod-1,包括svc的负载均衡。 这是什么原因导致
从以上问题描述中得到以下信息:
master01,node01:pod2,node02:pod01。问题出在node02中的pod01无法被访问
排除了nginx镜像,svc标签选择器,网络问题。下一步就是缩小可能错误范围。
“为什么会产生这样的错误呢,两个node机器完全一致,不应出现一个能一个不能用(跨节点不可访问)的情况”
先检查一下Endpoints(负载均衡依赖关联)
kubectl get endpoints myapp
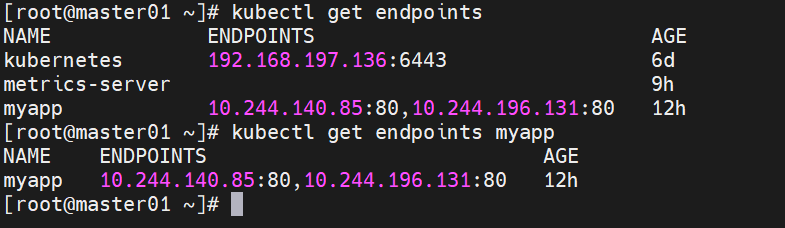
发现正常存在pod-1,pod-2所在两台机器的IP,说明service正确关联两个pod(还是标签无误的进阶检查)
以上测试通过,检查CNI网络插件(本机用的是calico,别的有Flannel,weave等)
发现错误,显示有一个calico处于“崩溃循环回退”状态:
尝试删除calico-node,让它重新生成,成功则是偶发现象。可惜了士兵,这次没有那么幸运。
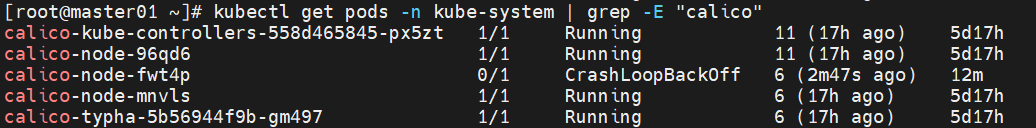
那我们看看这个崩溃的calico-node的日志
kubectl logs calico-node-fwt4p -n kube-system --previous
(没有现场照片了,下面的都是复现图片,仅供参考)
发现日志中有如下内容,且在重复出现
2025-10-18 06:51:27.994 [ERROR][1935] status-reporter/discovery.go 235: Didn't find any ready Typha instances.
2025-10-18 06:51:27.995 [ERROR][1905] felix/daemon.go 353: Typha discovery enabled but discovery failed. error=Kubernetes service missing IP or port
bird: Unable to open configuration file /etc/calico/confd/config/bird.cfg: No such file or directory
calico-node无法发现calico-typha服务,进而导致后续Brid配置文件无法生成,使得calico-node启动失败
检查calico-typha Service是否运行正常
kubectl get svc calico-typha -n kube-system
service存在,看不出来什么,进一步看一下,calico-typha的endpoints是否有就绪实例(熟悉不,就这个流程)
kubectl get endpoints calico-typha -n kube-system
哎!输出怎么没有endpoint!找到错误入口了
那么说明calico-typha pod未就绪或者未运行,进一步检查typha pod状态
kubectl get pods -n kube-system -l k8s-app=calico-typha
发现pod运行但是没有就绪,即running但是 ready:0/1
好,那么检查探针,其中的pod名来自上面那个命令
kubectl describe pod calico-typha-5b56944f9b-gm497 -n kube-system | grep Readiness
Readiness: http-get http://localhost:9098/readiness delay=0s timeout=10s period=10s #success=1 #failure=3
typha运行但未就绪,看看日志
kubectl logs calico-typha-5b56944f9b-gm497 -n kube-system --previous
2025-10-17 13:05:50.317 [INFO][7] sync_server.go 637: Closing connection; reason: graceful shutdown in progress. connID=0x17 remainingConns=1 thread="gracefulShutdown"
2025-10-17 13:05:50.317 [INFO][7] sync_server.go 604: Finished closing connections, completing shut down... remainingConns=1 thread="gracefulShutdown"
... ...
2025-10-17 13:05:50.884 [INFO][7] sync_server.go 1076: KV-sender goroutine finished client=192.168.197.136:47516 connID=0x17 thread="kv-sender" type="felix"
2025-10-17 13:05:50.886 [INFO][7] sync_server.go 723: Client connection shut down. client=192.168.197.136:47516 connID=0x17 type="felix"
2025-10-17 13:05:50.886 [INFO][7] sync_server.go 476: Connection handler finished error=context canceled
2025-10-17 13:05:50.886 [FATAL][7] daemon.go 469: Server has shut down.
好一个优雅关闭,不断关闭。。。
陷入循环重启关闭了!
考虑:OOM(内存溢出)导致关闭
kubectl describe pod calico-typha-5b56944f9b-gm497 -n kube-system | grep -A 5 "Resources"
可是没有输出,是不是没有OOM事件,那么就只能是存活探针了
杰哥说过:当存活探针的超时时间(initialDelaySeconds)过短,就会导致重启循环。
kubectl describe pod calico-typha-5b56944f9b-gm497 -n kube-system | grep -A 5 "Liveness"
30秒,先试着改一下
Liveness: http-get http://localhost:9098/liveness delay=30s timeout=10s period=10s #success=1 #failure=3
kubectl edit deployment calico-typha -n kube-system
#找到

livenessProbe:
  httpGet:
    path: /liveness
    port: 9098
  initialDelaySeconds: 60  # 延长启动延迟,给typha足够时间初始化
  timeoutSeconds: 10
  periodSeconds: 10
  failureThreshold: 3
验证结果(要有耐心,刷个朋友圈别着急)
kubectl get pods -n kube-system -l k8s-app=calico-typha
kubectl describe pod <calico-typha名> -n kube-system | grep "Ready"
若输出Ready: True,说明就绪探针通过,typha 已正常就绪。
然后就是删除node02机器上的calico-node,让系统重新生成,也要有耐心等一下
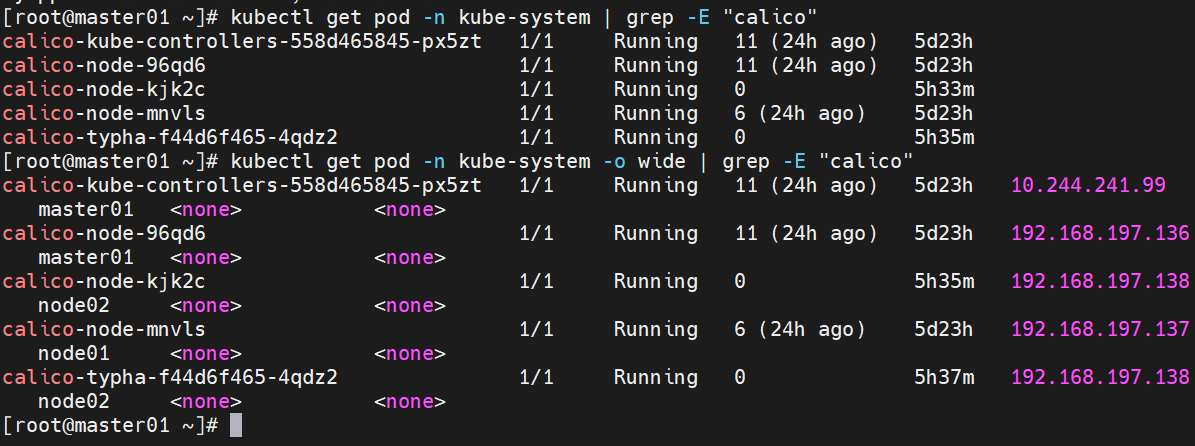
能解决99%的此情况下的问题
end